Domain lonesome-george.de kaufen?
Wir ziehen mit dem Projekt
lonesome-george.de um.
Sind Sie am Kauf der Domain
lonesome-george.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain lonesome-george.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Faktencheck ArtenvielfaltFaktencheck Artenvielfalt , Bestandsaufnahme und Perspektiven für den Erhalt der biologischen Vielfalt in Deutschland , Radlager > Gokart Teile , Erscheinungsjahr: 20241001, Produktform: Leinen, Redaktion: Wirth, Christian~Bruelheide, Helge~Farwig, Nina~Marx, Jori~Settele, Josef, Seitenzahl/Blattzahl: 1256, Keyword: Artenschutz; Artensterben; Biodiversität; Naturschutz; Tiere; Umwelt; Umweltschutz; Ökosysteme, Fachschema: Ökologie~Artenvielfalt (biologisch)~Biodiversität~Vielfalt (naturwissenschaftlich)~Artenschutz~Bedrohte Pflanzen u. Tiere~Naturschutz / Artenschutz~Rote Liste (biologisch), Fachkategorie: Tiere und Gesellschaft~Ökologie, Biosphäre~Biodiversität (Artenvielfalt), Warengruppe: HC/Ökologie, Fachkategorie: Artenschutz, Artensterben, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Oekom Verlag GmbH, Verlag: Oekom Verlag GmbH, Produktverfügbarkeit: 02, Länge: 297, Breite: 210, Höhe: 65, Gewicht: 3758, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,149,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **

Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
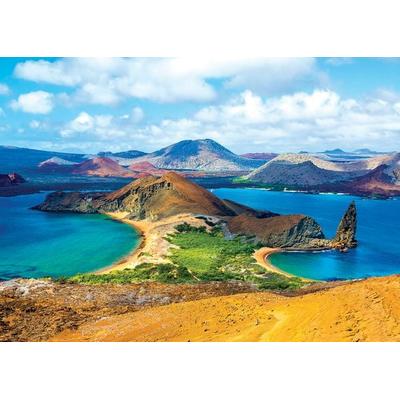
GalapagosinselnEurographics Rette Unseren Planeten - Galapagos 1000-teiliges Puzzle. Die Galapagosinseln Haben Eine Einmalige Flora Und Fauna, Da Sie Seit Milionen Von Jahren Von Jeglichem Festland Getrennt Sind Und Stehen Bis Zu 97% Unter Strengem Naturschutz....16,95 €*Versand: 2,95 €Sichere Weiterleitung zum Anbieter
-
Ein Gartenparadies für Schmetterlinge. Die schönsten Blumen, Stauden, Kräuter und Sträucher für Falter und ihre Raupen. Artenschutz und ArtenvielfaltEin Gartenparadies Für Schmetterlinge. Die Schönsten Blumen, Stauden, Kräuter Und Sträucher Für Falter Und Ihre Raupen. Artenschutz Und Artenvielfalt Im Eigenen Garten. Natürlich Bienenfreundlich., Gebundene Ausgabe Von Ursula Kopp, Bassermann,...9,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Faktencheck ArtenvielfaltFaktencheck Artenvielfalt , Bestandsaufnahme und Perspektiven für den Erhalt der biologischen Vielfalt in Deutschland , Radlager > Gokart Teile , Erscheinungsjahr: 20241001, Produktform: Leinen, Redaktion: Wirth, Christian~Bruelheide, Helge~Farwig, Nina~Marx, Jori~Settele, Josef, Seitenzahl/Blattzahl: 1256, Keyword: Artenschutz; Artensterben; Biodiversität; Naturschutz; Tiere; Umwelt; Umweltschutz; Ökosysteme, Fachschema: Ökologie~Artenvielfalt (biologisch)~Biodiversität~Vielfalt (naturwissenschaftlich)~Artenschutz~Bedrohte Pflanzen u. Tiere~Naturschutz / Artenschutz~Rote Liste (biologisch), Fachkategorie: Tiere und Gesellschaft~Ökologie, Biosphäre~Biodiversität (Artenvielfalt), Warengruppe: HC/Ökologie, Fachkategorie: Artenschutz, Artensterben, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Oekom Verlag GmbH, Verlag: Oekom Verlag GmbH, Produktverfügbarkeit: 02, Länge: 297, Breite: 210, Höhe: 65, Gewicht: 3758, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,149,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
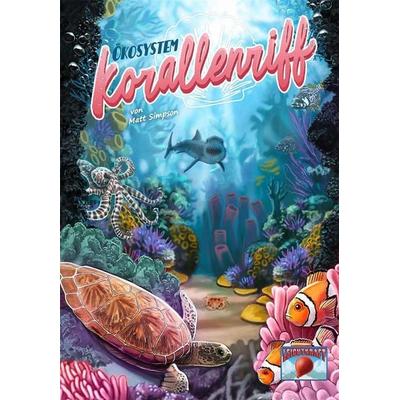
Ökosystem KorallenriffEntdecken Sie Das Faszinierende Ökosystem Korallenriff Mit Dieser Spielware. Ideal Für Kinder, Um Mehr Über Die Vielfalt Des Meereslebens Zu Lernen. Fördert Das Verständnis Für Die Bedeutung Von Korallenriffen Im Globalen Ökosystem. Perfekt Zum...14,99 €*Versand: 2,95 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.